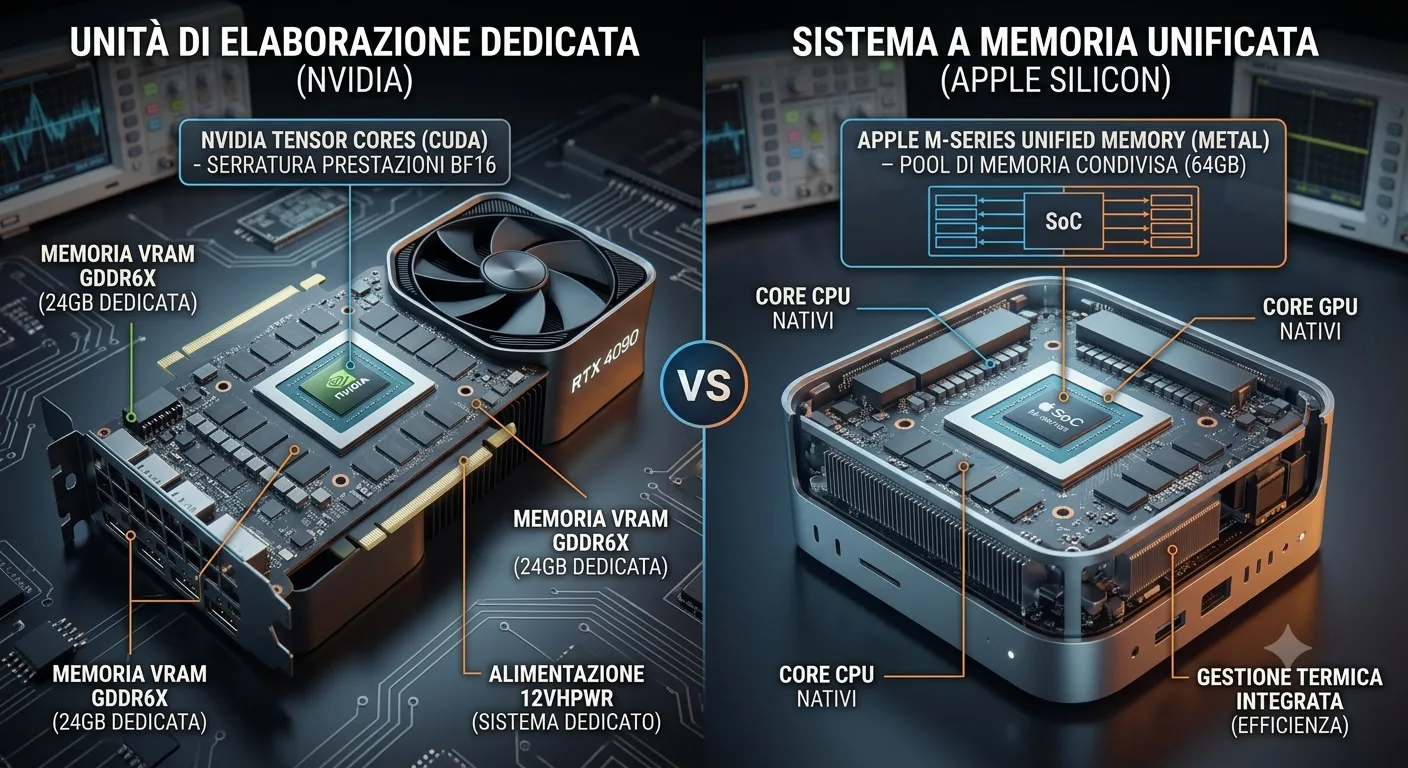
Nel panorama del Deep Learning locale, la scelta dell'hardware è storicamente ruotata attorno a un unico ecosistema: Nvidia e l'architettura CUDA. Negli ultimi anni, tuttavia, l'introduzione dell'architettura a Memoria Unificata (UMA) di Apple Silicon ha introdotto un paradigma alternativo.
Per chi fa training locale di modelli generativi (LoRA, Embeddings o Fine-Tuning di LLM e Modelli di Diffusione), il confronto non si riduce alla pura velocità di calcolo grezzo (TFLOPS). La vera partita si gioca sulla gestione dei colli di bottiglia della memoria, l'allocazione dei tensor buffer e l'efficienza degli ottimizzatori.
Ecco un'analisi tecnica approfondita di come le due architetture gestiscono i carichi di lavoro di training e come ottimizzare la pipeline per estrarre fino all'ultimo bit di performance da ciascun sistema.
Architettura della Memoria: Bandwidth vs Capacità di Allocazione
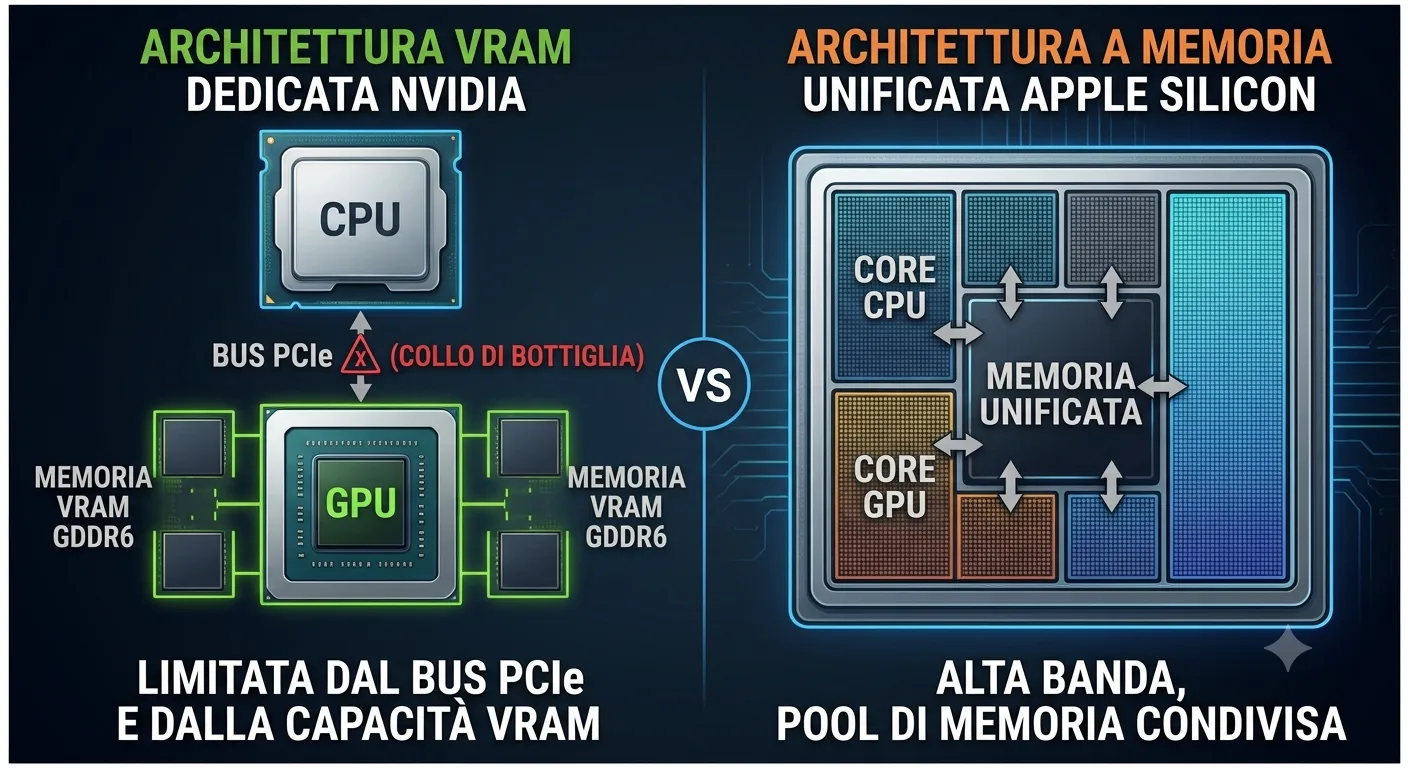
La differenza fondamentale tra i due sistemi risiede nel modo in cui la CPU e la GPU comunicano e accedono ai dati del dataset e ai pesi del modello.
NVIDIA ARCHITECTURE (Dedicata)
[ CPU ] <---- PCIe Bus (Collo di bottiglia) ----> [ GPU VRAM (Ultra-Veloce) ]

APPLE SILICON ARCHITECTURE (Unificata)
[ CPU / GPU / Neural Engine ] <==== Bus di Memoria ad Alta Velocità ====> [ RAM Unificata ]
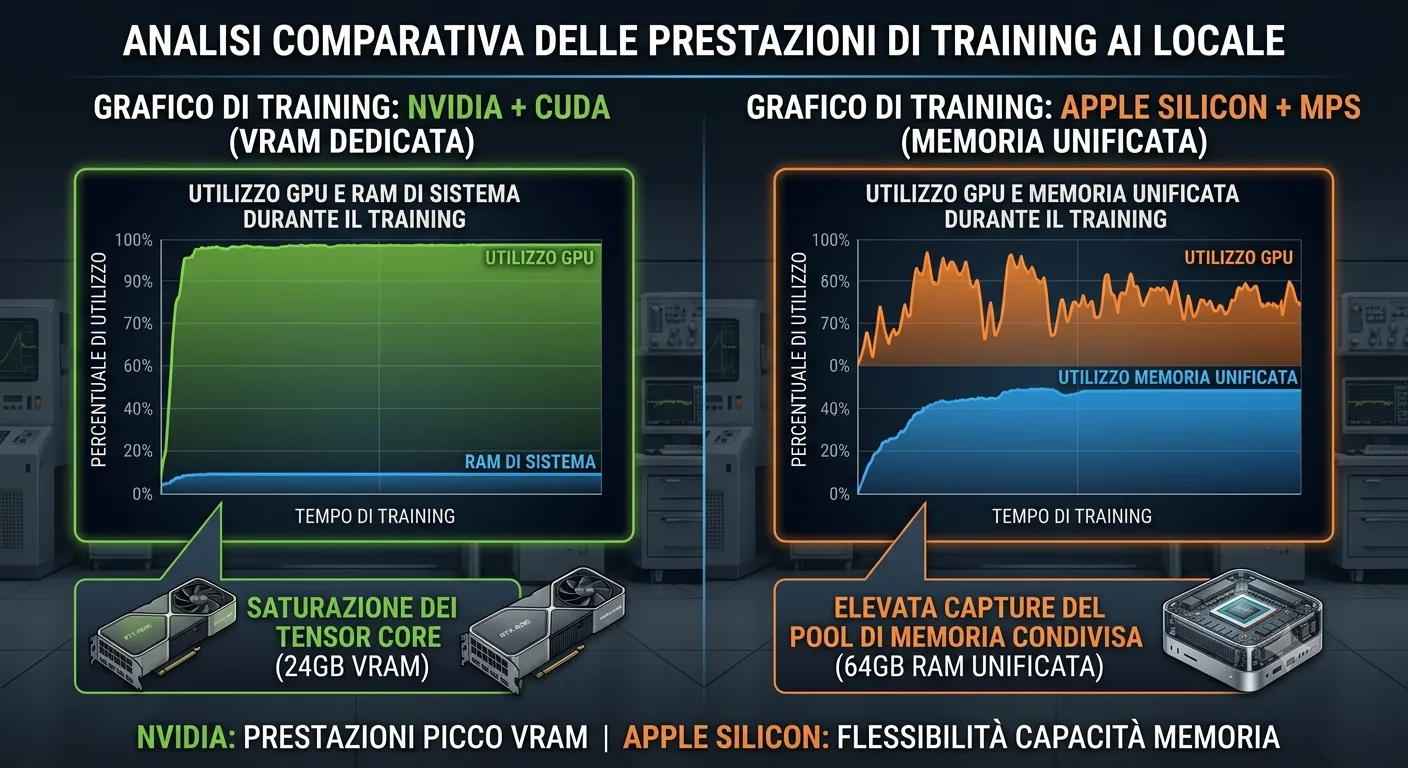
Nvidia: Il paradigma VRAM Dedicata
Nelle GPU Nvidia (es. architetture Ada Lovelace o Blackwell), la VRAM (GDDR6X o HBM) risiede fisicamente sulla scheda video.
-
Vantaggi: Il bandwidth interno è mostruoso (spesso superiore a 1 TB/s nelle schede di fascia alta), garantendo uno scambio di dati quasi istantaneo tra i Tensor Core e i registri di memoria durante i passaggi di Forward e Backward.
-
Svantaggi: Lo spazio è rigidamente limitato (es. 12GB, 16GB o 24GB nelle GPU consumer). Se il modello, il batch size e gli stati dell'ottimizzatore superano anche solo di 1 MB la capacità della VRAM, il sistema va in OOM (Out Of Memory) o è costretto a fare l'offloading sulla RAM di sistema tramite il bus PCIe, distruggendo le performance.
Apple Silicon: Il paradigma Memoria Unificata (UMA)
Sui chip Apple (M-Series Pro, Max e Ultra), CPU e GPU condividono lo stesso identico pool di memoria sul package del chip.
-
Vantaggi: Non esiste il concetto di "trasferimento dati" tra CPU e GPU. Quando un dataset di immagini viene caricato in memoria dalla CPU, la GPU può accedere a quei tensori istantaneamente nello stesso spazio di indirizzamento. Inoltre, le configurazioni possono raggiungere i 24GB, 48GB, sino a oltre 128GB di memoria accessibile dalla GPU.
-
Svantaggi: Il bandwidth, sebbene elevato per una memoria di sistema (fino a 400 GB/s su Max e 800 GB/s su Ultra), è inferiore a quello della VRAM dedicata di una GPU Nvidia top di gamma. Inoltre, il sistema operativo riserva una quota di questa RAM per le attività grafiche e di sistema, riducendo lo spazio utile effettivo.
La Battaglia degli Ottimizzatori: 8-bit AdamW vs MPS Nativi
Il training non è fatto solo di pesi del modello; gli stati dell'ottimizzatore spesso occupano il doppio o il triplo dello spazio del modello stesso. È qui che le due piattaforme divergono radicalmente nella gestione software.
Nvidia e l'ecosistema BitsAndBytes
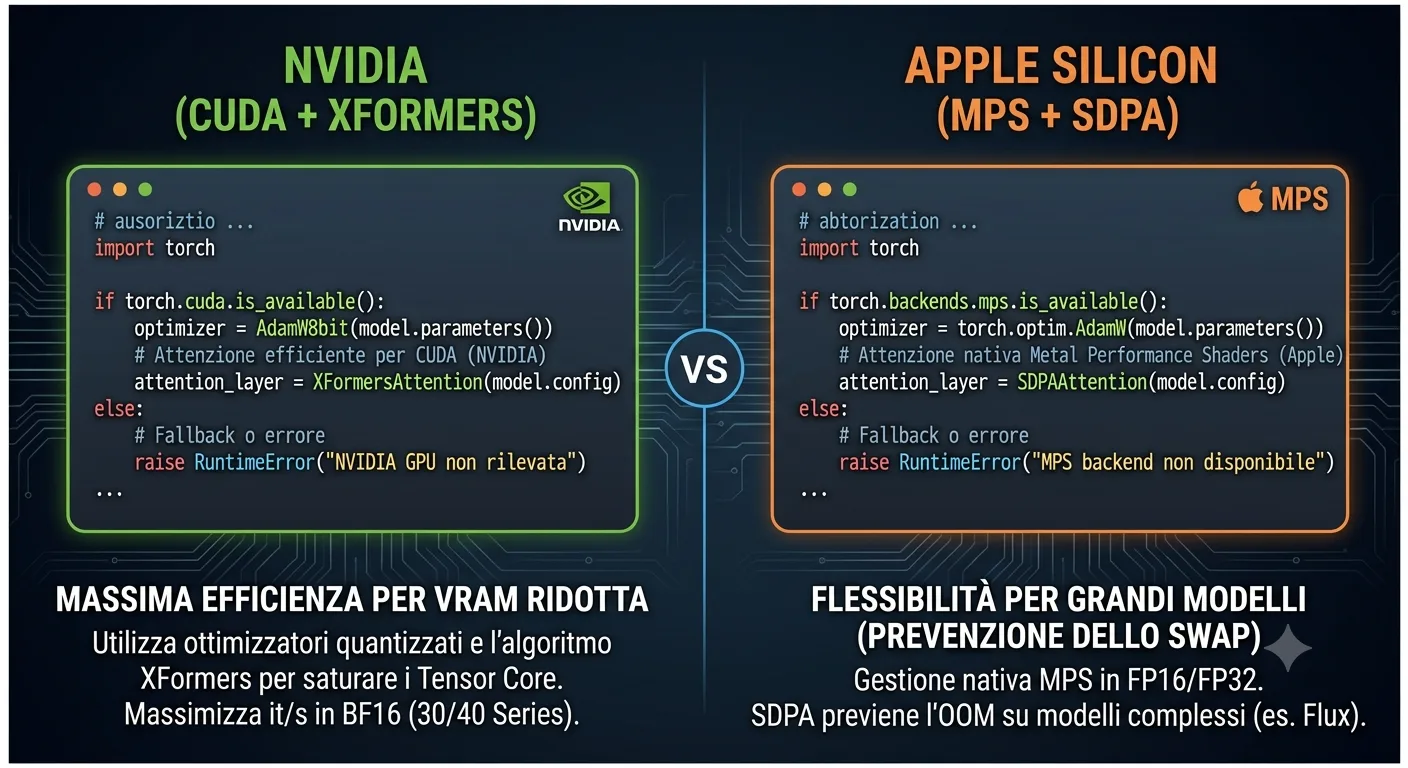
Su Nvidia, lo standard de facto per risparmiare VRAM è l'utilizzo di ottimizzatori quantizzati a 8-bit, come AdamW8bit (tramite la libreria bitsandbytes).
-
Un ottimizzatore standard FP32 richiede 8 byte di memoria per ogni parametro del modello.
-
Con
AdamW8bit, questa richiesta scende a 2 byte per parametro.Abbinando questo a precisioni miste come BF16 (Bfloat16), supportata nativamente dai Tensor Core, Nvidia riesce a mantenere l'impronta di memoria estremamente bassa senza degradare la convergenza del modello.
Apple Silicon e il framework MPS (Metal Performance Shaders)
Sotto macOS, PyTorch si affida al backend MPS. Storicamente, la libreria bitsandbytes non ha un supporto nativo completo e ottimizzato per MPS a 8-bit senza layer di traduzione pesanti.
-
Sul software di training locale (come Kohya_ss o script PyTorch custom), l'uso di ottimizzatori a 8-bit su Mac può causare instabilità o rallentamenti dovuti alla fallback sulla CPU.
-
La soluzione ottimale: Utilizzare ottimizzatori nativi scritti per Metal, come
AdamWstandard in precisione FP16, o ottimizzatori alternativi a basso consumo di memoria come Adafactor o Lion. Grazie all'ampia disponibilità di RAM unificata (es. su macchine da 24GB o superiori), l'assenza degli 8-bit viene compensata dalla capacità fisica di ospitare stati dell'ottimizzatore più pesanti in FP16/FP32.
Commenti (0)
Ancora nessun commento. Inizia tu la discussione.